Un agent utile sur une tâche isolée peut fonctionner sans mémoire longue. Une flotte agentique, elle, doit conserver ce qu'elle apprend: décisions, préférences, erreurs, signaux opérationnels et contexte métier.
La mémoire persistante n'est pas un simple stockage de conversations. C'est une couche d'architecture qui organise ce qui doit être partagé, ce qui doit rester propre à un agent, et ce qui doit disparaître après une session.
Le problème: pourquoi le RAG ne suffit pas
Le RAG permet de récupérer des documents pertinents au moment de répondre. Il est précieux pour consulter une base documentaire, mais il ne résout pas le problème de l'expérience accumulée.
Une mémoire agentique doit conserver ce que le système apprend en travaillant: les décisions déjà prises, les préférences utilisateur, les erreurs corrigées, les résultats observés et les signaux utiles pour les prochaines tâches.
La différence est nette: le RAG demande ce que disent les documents. La mémoire demande ce que l'organisation a déjà appris.
Le système de mémoire à trois niveaux
La mémoire doit être segmentée. Sans séparation claire, le système mélange le contexte global, les habitudes propres à un agent et les détails temporaires d'une tâche en cours.
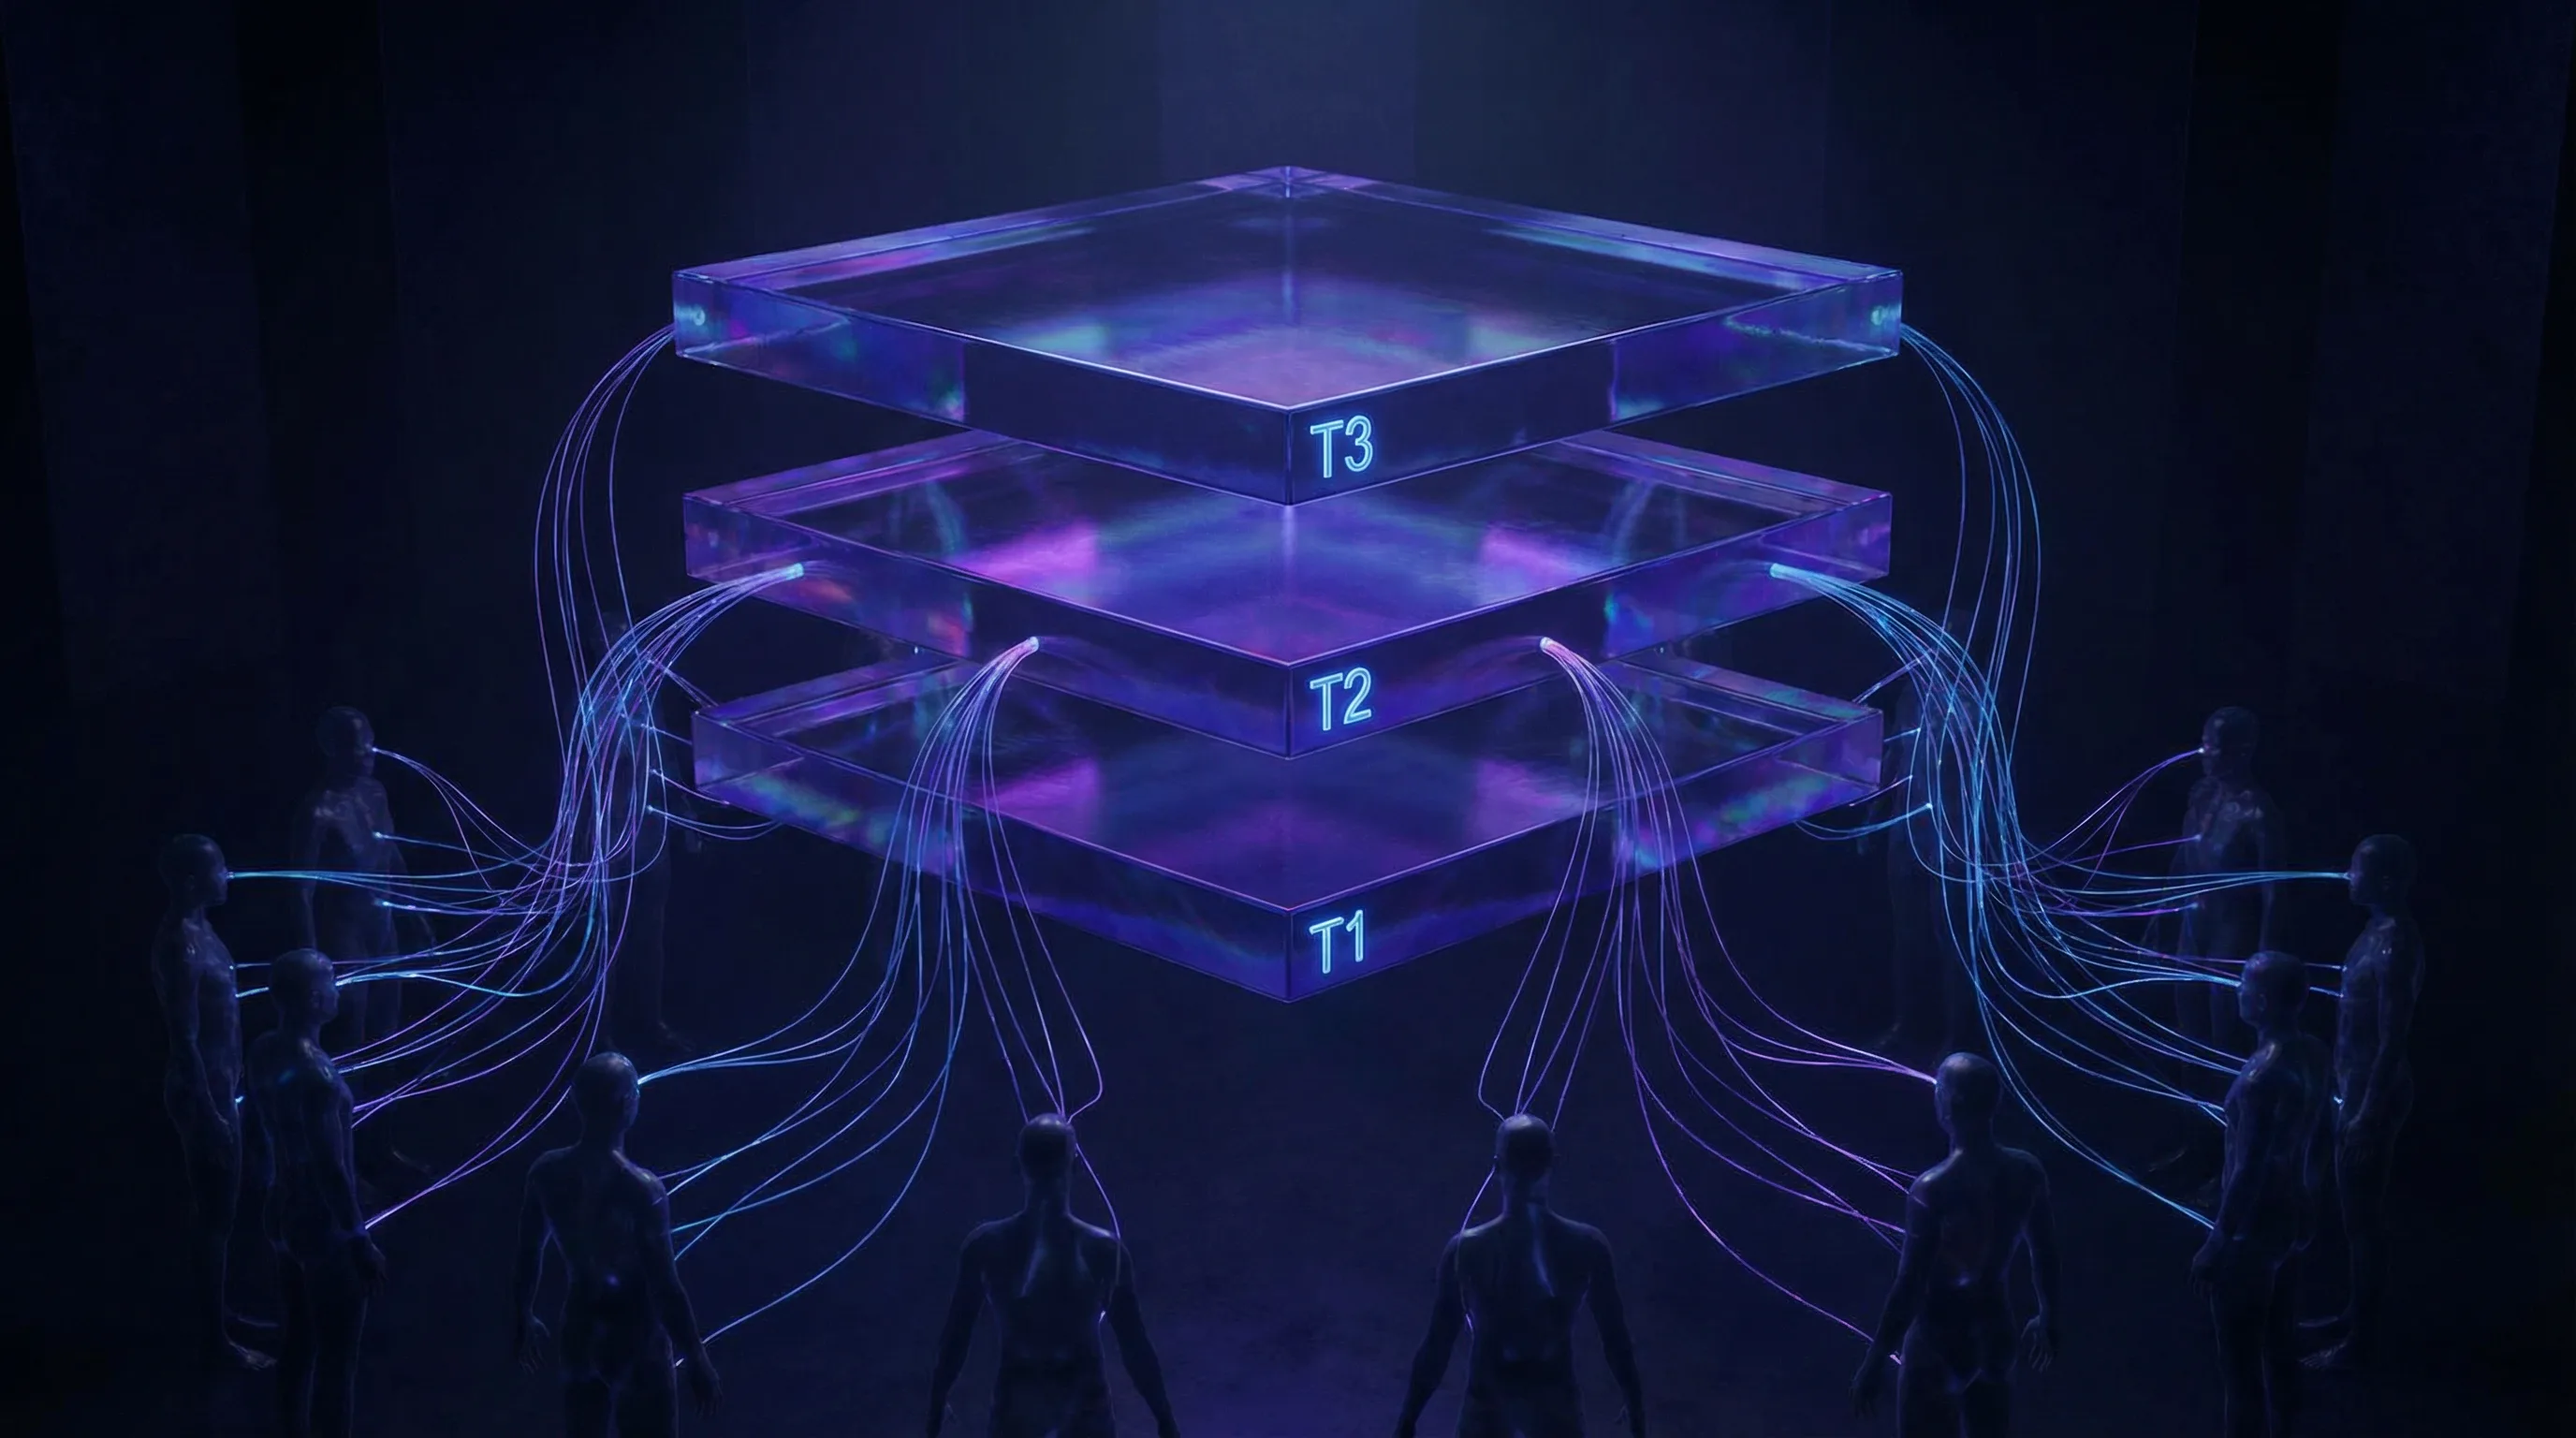
Une architecture à trois niveaux évite cette confusion: mémoire globale, mémoire propre à l'agent et mémoire de session.
Tier 1: mémoire globale
La mémoire globale contient ce que toute la flotte doit pouvoir connaître. Elle sert de socle commun pour maintenir une cohérence entre agents.
- Décisions structurantes prises par l'organisation.
- Règles métier, politiques internes et préférences globales.
- Connaissance de domaine utile à plusieurs agents.
- Contexte d'équipe, contraintes opérationnelles et conventions partagées.
- Signaux transverses qui améliorent la coordination entre agents.
Tier 2: mémoire propre à l'agent
Chaque agent développe une spécialité. Sa mémoire propre conserve les apprentissages liés à son rôle sans contaminer inutilement les autres agents.
Ce niveau évite deux dérives: un agent trop générique qui oublie son expertise, ou une mémoire globale saturée par des détails qui ne concernent qu'un seul métier.
- Préférences spécifiques à un agent ou à son domaine.
- Méthodes de travail et playbooks adaptés à son rôle.
- Erreurs déjà rencontrées et corrections appliquées.
- Signaux de performance liés à ses tâches récurrentes.
- Contexte spécialisé qui n'a pas vocation à être partagé par défaut.
Tier 3: mémoire de session
La mémoire de session correspond au contexte de travail temporaire. Elle garde les hypothèses, étapes intermédiaires et décisions locales nécessaires à l'exécution d'une tâche.
Ce niveau est volontairement éphémère. À la fin de la session, il faut décider ce qui doit être archivé, promu vers une mémoire plus durable ou supprimé.
- État courant d'une tâche ou d'une enquête.
- Hypothèses temporaires et éléments à vérifier.
- Résultats intermédiaires avant validation.
- Décisions locales qui ne doivent pas polluer la mémoire longue.
- Informations utiles uniquement pendant l'exécution.
Cycle de vie: créer, chercher, mettre à jour, archiver
La mémoire n'est pas seulement ajoutée au fil de l'eau. Elle doit avoir un cycle de vie explicite, sinon elle devient vite bruyante, contradictoire ou trop risquée.
- Créer une entrée avec un périmètre, une source, une date, une confiance et un niveau de visibilité.
- Chercher avec une combinaison de recherche sémantique, métadonnées, filtres et mots-clés.
- Mettre à jour quand un fait change, quand une préférence évolue ou quand une ancienne conclusion devient fausse.
- Archiver les entrées obsolètes sans perdre la trace historique.
- Journaliser les opérations de lecture, écriture, modification et suppression.
Partage inter-agents contrôlé
La mémoire partagée ne doit pas devenir un espace ouvert où tout agent lit tout. Le partage doit être utile, traçable et limité par des règles.
Un agent peut bénéficier d'un apprentissage produit par un autre agent, mais seulement si la politique d'accès l'autorise et si le contexte ne transporte pas de données sensibles hors de son périmètre.
- Autoriser certaines lectures entre agents selon le rôle et le domaine.
- Contrôler les données qui peuvent être promues vers la mémoire globale.
- Éviter les demandes d'autorisation permanentes en définissant des politiques claires.
- Tracer quel agent a consulté quelle mémoire et pour quelle opération.
- Prévenir la fuite de contexte entre domaines qui ne doivent pas se mélanger.
La stack: mem0 + Qdrant + Ollama local
Une architecture de mémoire peut s'appuyer sur mem0 pour gérer les opérations de mémoire, Qdrant pour la recherche vectorielle et Ollama en local pour les embeddings.
Ce choix garde les données proches de l'organisation, réduit la dépendance à des services externes et rend le système plus prévisible côté confidentialité, coût et latence.
La recherche vectorielle reste utile, mais elle ne suffit pas seule. Les métadonnées, les filtres et la recherche textuelle classique restent nécessaires pour obtenir des résultats fiables.
L'interface: six outils, une mémoire
Une bonne mémoire agentique doit être visible. Les équipes doivent pouvoir chercher, filtrer, comprendre et corriger ce que les agents retiennent.

1. Long-Term Memory
La mémoire long terme conserve les faits durables. Elle contient les éléments qui doivent rester disponibles au-delà d'une tâche ou d'une conversation.
Chaque entrée doit être contextualisée: type de mémoire, niveau de partage, agent concerné, confiance, tags, date et origine.
2. Field View
La vue terrain donne une lecture opérationnelle de la mémoire. Elle permet de filtrer par agent, domaine, niveau, date ou statut pour comprendre ce qui influence réellement les décisions.
Cette vue est essentielle pour éviter que la mémoire devienne une boîte noire.
3. Daily Journal
Le journal quotidien transforme l'activité agentique en chronologie compréhensible. Il relie les tâches, décisions, apprentissages et événements dans une narration exploitable.
Cette couche aide les humains à suivre ce qui s'est passé sans relire toutes les traces techniques.
4. Knowledge Base
La base de connaissance contient le savoir stabilisé. Elle complète la mémoire en offrant des références plus durables, plus propres et plus faciles à consulter.
Elle sert de bibliothèque maîtrisée pendant que la mémoire capture les apprentissages issus de l'exécution.
5. Meditation
La consolidation périodique permet à la mémoire de s'améliorer. Elle identifie les contradictions, résume les signaux répétés, nettoie le bruit et propose des entrées plus fiables.
Sans ce travail de réflexion, la mémoire accumule trop vite des fragments peu utiles.
6. mem0 Admin
La vue d'administration sert aux équipes techniques. Elle permet de surveiller le stockage, les opérations, les migrations, les performances et la qualité des entrées.
Une mémoire agentique doit être exploitable comme un composant de production, pas comme une simple fonctionnalité cachée.
Privacy by design: toutes les données restent on-premise
La mémoire est sensible parce qu'elle contient ce que le système apprend dans la durée. Elle peut révéler des préférences, des décisions internes, des erreurs, des méthodes de travail et parfois des informations confidentielles.
Garder les embeddings, métadonnées, journaux et entrées mémoire sur l'infrastructure maîtrisée réduit le risque de fuite et simplifie la gouvernance.
- Les vecteurs et métadonnées restent dans l'environnement contrôlé.
- Les journaux et historiques ne dépendent pas d'un service cloud tiers.
- Les politiques de rétention et de suppression restent sous contrôle interne.
- Les audits peuvent relier les accès mémoire aux agents et aux opérations.
- Le système dépend moins des limites, coûts et disponibilités des API externes.
Intégrations clients: plusieurs outils, une mémoire
La mémoire devient plus utile quand plusieurs clients peuvent s'y connecter: interfaces internes, outils développeur, notebooks, orchestrateurs ou API.
L'important est que ces clients utilisent la même couche de mémoire, avec les mêmes règles d'accès et les mêmes traces. Sinon, chaque outil reconstruit son propre historique et la coordination se fragmente.
Retours d'expérience
La séparation en trois niveaux apporte une structure claire. Elle réduit la surcharge cognitive, évite la pollution de la mémoire globale et permet aux agents de conserver leur spécialité.
Les embeddings locaux demandent un effort d'intégration, mais ils apportent un meilleur contrôle opérationnel. L'archivage est également important: supprimer trop vite fait perdre l'historique, mais tout garder dans la mémoire active dégrade la qualité.
- Ce qui fonctionne bien: séparation des niveaux, mémoire propre par agent, stockage local, consolidation et archivage.
- Ce qui demande plus de soin: niveaux de confiance, politiques d'accès entre agents et qualité de la recherche.
- La recherche vectorielle doit être complétée par des filtres, des métadonnées et parfois des mots-clés exacts.
- Les entrées mémoire doivent pouvoir être corrigées ou retirées quand elles deviennent fausses.
Suite logique
La mémoire persistante devient rapidement une capacité centrale pour les agents de production. Elle leur permet de progresser au lieu de repartir de zéro.
Mais plus la mémoire est riche, plus le risque augmente: une mauvaise requête, un mauvais routage ou un prompt mal maîtrisé peut faire ressortir des informations sensibles.
La couche suivante consiste donc à contrôler ce qui sort de la mémoire avant d'être transmis aux modèles, avec des règles de nettoyage, de minimisation et de classification des données.
Standards à garder en tête
- OWASP LLM06, Sensitive Information Disclosure: éviter que le système expose des informations sensibles.
- OWASP LLM08, Excessive Agency: limiter ce qu'un agent peut faire avec les informations qu'il récupère.
- RGPD, article 5: minimisation, limitation des finalités et exactitude des données.
- RGPD, article 32: sécurité du traitement et mesures techniques adaptées.
Points clés
- Le RAG récupère des documents; la mémoire conserve l'expérience opérationnelle.
- Trois niveaux évitent de mélanger contexte global, expertise agent et travail temporaire.
- La mémoire doit être auditée, gouvernée et classée, pas seulement stockée.
- Le stockage local réduit la dépendance fournisseur et protège le contexte appris.
- La recherche vectorielle doit être complétée par des métadonnées, des mots-clés et des règles d'accès.